https://pepper.pl

Pepper.pl to popularna platforma, skupiająca się na promocjach, zniżkach i okazjach zakupowych. Użytkownicy mogą przeglądać i udostępniać oferty, kupony rabatowe oraz informacje o promocjach, dzieląc się nimi z innymi użytkownikami.

Dane zawarte na Pepper.pl umożliwiają śledzenie trendów zakupowych, analizę preferencji klientów oraz monitorowanie konkurencji. Dostęp do cennych informacji pozwala zoptymalizować strategie marketingowe, dotrzeć do szerszego grona odbiorców i zwiększyć konkurencyjność na rynku.
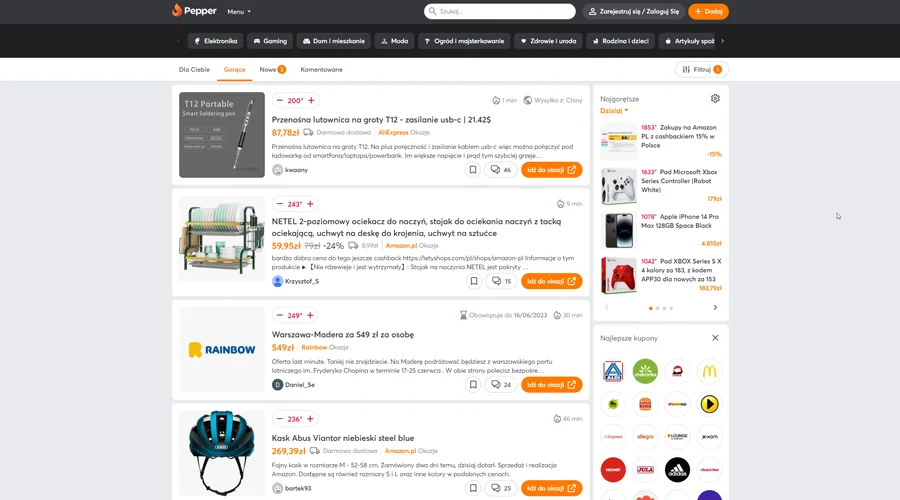
Przykłady źródeł danych

Poniżej prezentujemy przykładowe źródła, które mogą zawierać interesujące dla Ciebie dane.
Bardziej obszerna lista znajduje się w naszym katalogu źródła danych.

Potrzebujesz innego źródła?

Skontakuj się z nami i zamów bezpłatną wycenę!

Jak pobrać dane z pepper.pl?

Pepper.pl to serwis społecznościowy, w którym okazje publikują użytkownicy, a o ekspozycji oferty decyduje głosowanie społeczności, nie budżet reklamowy sklepu. Dla zespołów analitycznych oznacza to dwie warstwy danych zamiast jednej: warstwę transakcyjną (cena bieżąca, cena poprzednia, wysokość rabatu, koszt dostawy, kod rabatowy, sklep docelowy) oraz warstwę sygnałową (temperatura okazji, głosy w górę i w dół, liczba komentarzy, liczba zapisań). Struktura jest dwuwarstwowa. Pipeline DataMiners mapuje obie warstwy — łącznie 32 pola rozłożone na 6 grup — tak, aby cena i reakcja rynku na tę cenę trafiały do jednego rekordu z jednym znacznikiem czasu.

Uruchomienie przebiega w trzech krokach. Klient opisuje potrzeby: które kategorie, które sklepy, jaki horyzont czasowy i jaka częstotliwość. Zespół DataMiners buduje pipeline — obsługę paginacji list okazji, wejście w kartę pojedynczej oferty, normalizację cen do jednej waluty i jednego formatu liczbowego, deduplikację powtórzonych zgłoszeń tej samej promocji oraz walidację kompletności rekordu. Trzeci krok to dostawa danych w ustalonym formacie i kadencji. Zakres ustala klient. Bezpłatna wycena wraca w 24 godziny robocze, a cena zależy od zakresu pól, częstotliwości odświeżania i formatu wyjścia.

Odświeżanie ustalane jest indywidualnie w dwóch wariantach: dobowym albo godzinowym. Kadencja dobowa wystarcza do analiz trendu kategorii i raportowania promocyjnego w rytmie tygodniowym, natomiast kadencja godzinowa obsługuje przypadki, w których liczy się moment publikacji okazji — okna wyprzedażowe, Black Friday, reakcja na promocję konkurenta. Dane trafiają do klienta w JSON, CSV lub XLSX, albo bezpośrednio przez API do własnego magazynu danych. Warstwa sygnałowa jest zmienna w czasie: temperatura okazji i liczba komentarzy rosną po publikacji, więc pipeline zapisuje snapshoty z polem scraped_at zamiast nadpisywać rekord, co pozwala odtworzyć krzywą reakcji społeczności na konkretną ofertę.

Wszystkie pola danych z pepper.pl

Standardowy zakres to 32 pól z każdej karty produktu. Dostarczamy je w JSON, CSV, XLSX albo przez API — w tym samym schemacie niezależnie od formatu.

identyfikacja_okazji
deal_iddeal_urldeal_titledeal_typecategory_pathposted_atexpires_at
cena_i_rabat
current_priceprevious_pricediscount_percentagecurrencyshipping_costis_free_shipping
sklep_i_przekierowanie
merchant_namemerchant_urldestination_urlvoucher_codeis_affiliate_link
sygnaly_spolecznosci
temperature_scorevotes_upvotes_downcomment_countsaved_countis_hot
autor_zgloszenia
author_usernameauthor_profile_urlauthor_reputation_level
tresc_i_metadane
description_textimage_urltags_listis_expiredscraped_at

Jak firmy wykorzystują dane z pepper.pl

Pricing Manager w e-commerce

Zestawienie pól current_price, previous_price i discount_percentage z sygnałem temperature_score pokazuje nie tylko poziom rabatu w kategorii, ale też próg, przy którym rabat zaczyna generować reakcję. Dobowa kadencja odświeżania wystarcza do budowy krzywej rabatowej per kategoria; godzinowa obsługuje okna wyprzedażowe. Pole voucher_code ujawnia dodatkowo rabat warunkowy, którego nie widać w cenie katalogowej sklepu.

Category Manager u producenta FMCG

Pola merchant_name, category_path i tags_list pozwalają odtworzyć, którzy dystrybutorzy wystawiają produkty marki w promocji i w jakim otoczeniu konkurencyjnym. Rynek dokumentuje tu zjawisko rabatu poza kontrolą producenta: promocja pojawia się w kanale, choć nie wynika z uzgodnionego planu handlowego. Zestaw 32 pól obejmuje zarówno cenę, jak i sklep docelowy, więc rekord wskazuje źródło rabatu.

Head of Competitive Intelligence

Warstwa sygnałowa — votes_up, votes_down, comment_count, saved_count — jest w praktyce publicznym pomiarem odbioru oferty konkurenta, dostępnym bez badania konsumenckiego. Snapshoty ze znacznikiem scraped_at odtwarzają dynamikę reakcji w czasie, a description_text i komentarze wskazują powtarzające się zastrzeżenia wobec produktu lub sklepu. Pipeline dostarcza te dane w JSON lub przez API do istniejącego środowiska analitycznego.

E-commerce Director

Pola posted_at, expires_at i is_expired opisują długość życia promocji w kategorii, a is_free_shipping oraz shipping_cost domykają rachunek kosztu koszyka, który klient końcowy porównuje z ofertą sklepu. Dwie kadencje odświeżania — dobowa i godzinowa — obsługują odpowiednio raportowanie planistyczne i reakcję operacyjną. Zakres pól i częstotliwość ustalane są przed uruchomieniem pipeline'u.

Najczęściej zadawane pytania

jak pobrać dane z pepper.pl

Dane z pepper.pl pobiera managed pipeline DataMiners: klient opisuje zakres, zespół buduje i utrzymuje pipeline, dane trafiają do odbiorcy w ustalonym formacie. Standardowy zestaw obejmuje 32 pola w 6 grupach — identyfikacja okazji, cena i rabat, sklep, sygnały społeczności, autor zgłoszenia, metadane. Zakres pól jest konfigurowalny i ustalany na etapie wyceny.

czy scrapowanie pepper.pl jest legalne

Pipeline obejmuje wyłącznie treści dostępne publicznie, bez logowania i bez obchodzenia zabezpieczeń technicznych. Zakres każdego wdrożenia ustalany jest z klientem i uwzględnia regulamin serwisu oraz przepisy o ochronie danych osobowych — pola takie jak author_username i author_profile_url dotyczą osób fizycznych, więc ich przetwarzanie wymaga podstawy prawnej po stronie klienta. DataMiners nie zastępuje opinii prawnej i standardowo rekomenduje jej uzyskanie przed uruchomieniem projektu.

jak często można odświeżać dane z pepper.pl

Dostępne są dwie kadencje: dobowa i godzinowa, ustalane indywidualnie z klientem. Kadencja dobowa obsługuje raportowanie trendu kategorii, godzinowa — okna wyprzedażowe i monitoring reakcji na promocję konkurenta. Sygnały społeczności zmieniają się w ciągu godzin od publikacji okazji, więc częstsze odświeżanie ma sens wyłącznie tam, gdzie analizowana jest dynamika, a nie stan końcowy.

w jakim formacie dostanę dane z pepper.pl

DataMiners dostarcza dane w JSON, CSV, XLSX albo przez API. Wybór zależy od miejsca docelowego: JSON i API sprawdzają się przy zasilaniu hurtowni danych i narzędzi BI, CSV i XLSX przy pracy analitycznej w arkuszu. Format ustalany jest przed uruchomieniem pipeline'u i wchodzi do wyceny.

czy pepper.pl ma API do pobierania okazji

Pipeline DataMiners nie zakłada dostępu do oficjalnego interfejsu serwisu — dane pochodzą z publicznie dostępnej warstwy pepper.pl, a klient otrzymuje własny endpoint API po stronie DataMiners. Jeżeli źródło udostępnia oficjalny interfejs w zakresie objętym projektem, pipeline korzysta z niego w pierwszej kolejności. Weryfikacja dostępnych ścieżek dostępu należy do pierwszego etapu, przed wyceną.

ile kosztuje pobieranie danych z pepper.pl

Cena jest indywidualna i zależy od trzech zmiennych: zakresu pól, częstotliwości odświeżania i formatu dostawy. Projekt obejmujący 32 pola w kadencji godzinowej wycenia się inaczej niż wąski zestaw cenowy odświeżany raz na dobę. Bezpłatna wycena wraca w 24 godziny robocze od opisu potrzeb.

jakie dane można wyciągnąć z pepper.pl

Standardowy zakres to 32 pola pogrupowane w 6 kategorii: identyfikacja okazji (deal_id, deal_url, posted_at, expires_at), cena i rabat (current_price, previous_price, discount_percentage, shipping_cost), sklep i przekierowanie (merchant_name, destination_url, voucher_code), sygnały społeczności (temperature_score, votes_up, votes_down, comment_count), autor zgłoszenia oraz metadane rekordu. Zakres można zawęzić lub rozszerzyć na etapie ustalania wymagań.